Erreurs d’indexation : comment interpréter les statuts de Google Search Console ?

Article par Audrey L.
Google Search Console peut afficher de nombreuses pages comme « non indexées ». Pourtant, toutes ne correspondent pas à de véritables erreurs d’indexation. Une redirection volontaire, une balise noindex ou une URL canonique peuvent expliquer cette absence. L’enjeu consiste donc à comprendre chaque statut avant d’en tirer des conclusions. Quatre questions orientent la lecture : que signifie-t-il, pourquoi Google l’affiche, la situation est-elle normale et quand faut-il intervenir ? Cette méthode aide à distinguer les exclusions attendues des problèmes susceptibles d’affecter la visibilité.
Points essentiels à retenir
- Toutes les erreurs d'indexation signalées dans Google Search Console ne correspondent pas à de véritables problèmes SEO : certaines exclusions sont volontaires et cohérentes avec la structure du site.
- Les statuts « Détectée, actuellement non indexée » et « Explorée, actuellement non indexée » indiquent deux étapes différentes du traitement d’une URL par Google.
- Les URL canoniques, les redirections, les 404 et les directives noindex doivent toujours être interprétées selon l’objectif réel de la page concernée.
- Les erreurs serveur 5xx, les blocages involontaires par robots.txt ou les exclusions accidentelles de pages importantes méritent une attention plus rapide.
- La priorité repose sur la valeur de l’URL, son rôle SEO et l’évolution du statut dans le temps, plutôt que sur le simple nombre de pages non indexées.
Ne pas confondre les statuts « détectée » et «explorée »
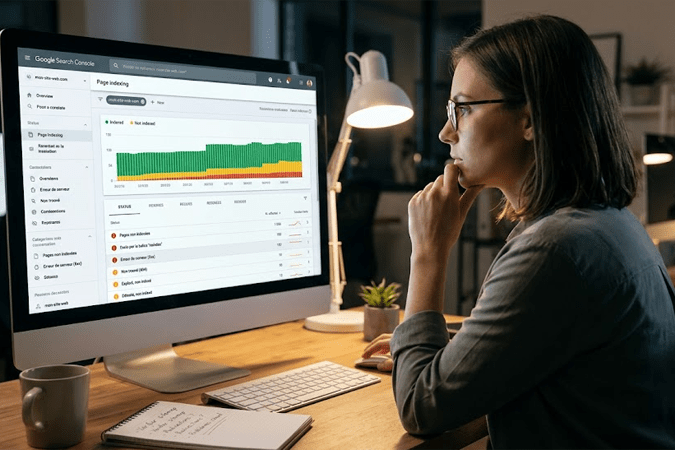
Ces statuts concernent une URL absente de l’index, mais pas au même stade. Pour comprendre ces erreurs d’indexation, un point compte. Googlebot a-t-il déjà visité la page ?
« Détectée, actuellement non indexée » : Google connaît l’URL sans l’avoir explorée
Google a identifié la page sans l’avoir encore explorée. Si la situation persiste, le maillage interne, le sitemap XML et la place de l’URL dans l’architecture peuvent être examinés.
Lorsque plusieurs pages importantes restent concernées, un accompagnement en référencement naturel peut aider à repérer des freins techniques.
« Explorée, actuellement non indexée » : Google a déjà visité l’URL
Googlebot a déjà accédé à l’URL, mais celle-ci n’a pas intégré l’index Google. Elle peut encore l’être plus tard.
La valeur du contenu, sa proximité avec d’autres pages et ses signaux de canonicalisation peuvent alors être étudiés. Une lecture au cas par cas reste préférable.
Vérifier si Google retient la bonne URL
Google peut rencontrer plusieurs versions proches d’un contenu. Ces statuts d’indexation deviennent importants lorsque l’URL canonique retenue diffère de celle que l’entreprise souhaite positionner.
« Autre page avec balise canonique correcte » : aucune intervention nécessaire
Ce statut indique que l’URL est une variante d’une autre page considérée comme principale. Si la page canonique retenue correspond à celle attendue, aucune correction n’est nécessaire.
Cette configuration permet à Google de privilégier la version canonique plutôt que d’indexer séparément plusieurs URL similaires. La cohérence des signaux reste utile à contrôler.
« Page en double » : vérifier la version choisie par Google
Sans canonique claire, Google peut sélectionner lui-même la version principale. La situation reste acceptable si son choix correspond à l’URL souhaitée.
Sinon, les balises canonical, le maillage, le sitemap et la similarité des contenus peuvent révéler des signaux contradictoires.
Déterminer si les redirections, 404 et Soft 404 nécessitent une correction
Une URL peut sortir de l’index parce qu’elle a changé d’adresse ou n’existe plus. Ces erreurs d’indexation n’ont pas toutes la même gravité : tout dépend du rôle de l’URL.
Remplacer une ancienne adresse par une page avec redirection
Lorsqu’une page redirige vers une autre adresse, l’ancienne URL n’a généralement plus vocation à être indexée. La destination devient l’élément principal à contrôler.
Une anomalie apparaît si la redirection mène vers une mauvaise page, crée une boucle ou une chaîne trop longue.
Distinguer une erreur 404 d’un Soft 404
Une 404 signifie que la ressource n’existe plus. Elle peut être normale après une suppression définitive. Elle mérite plus d’attention si l’URL reste dans le sitemap XML ou reçoit encore des liens internes.
Le Soft 404 concerne une page accessible dont le contenu ressemble à une page inexistante. Le code HTTP et le contenu servi doivent alors être analysés ensemble.
Identifier la nature du blocage
Certaines pages sont exclues volontairement, d’autres deviennent difficiles à explorer. Ces erreurs d’indexation se lisent selon l’intention du site et la nature du blocage.
Vérifier si l’exclusion par noindex est volontaire ou une mauvaise configuration
La directive noindex indique qu’une page ne doit pas apparaître dans l’index. Si ce choix est volontaire, le statut est cohérent.
Le problème apparaît lorsqu’elle touche une fiche produit, une page service ou un contenu destiné à attirer du trafic. Une URL commerciale marquée noindex par erreur peut perdre sa visibilité SEO.
Distinguer un blocage par robots.txt d’une erreur serveur 5xx
Le fichier robots.txt peut limiter l’exploration d’URL. Une règle trop large risque de bloquer des pages utiles.
Une erreur 5xx signifie que le serveur n’a pas répondu correctement. Si elle se répète, les logs serveur aident à mesurer le problème.
Quelles erreurs d’indexation faut-il corriger en priorité ?
Tous les signalements de Search Console ne nécessitent pas la même réaction. Pour hiérarchiser les erreurs d’indexation, la valeur de l’URL reste déterminante : devait-elle apparaître dans Google et contribue-t-elle aux conversions ?
La fonction de la page fixe la priorité
Une redirection volontaire, une canonical correcte ou un noindex prévu peuvent correspondre au fonctionnement normal. À l’inverse, une page commerciale inaccessible ou exclue par erreur mérite une analyse plus rapide.
Cette logique rejoint l’article sur ce qu’un audit SEO permet de découvrir sur un site. Il donne la possibilité d’aider à distinguer les blocages pénalisants des optimisations secondaires.
Les variations soudaines sont plus révélatrices qu’un chiffre isolé
Une hausse brutale des 5xx, des Soft 404 ou des pages importantes exclues peut révéler une migration ou un changement de configuration.
Le statut gagne donc à être lu avec le type de page et son historique. Cette méthode cible les problèmes d’indexation susceptibles d’affecter le trafic organique.
Pour conclure, les erreurs d’indexation ne se résument pas à la mention « Non indexée » dans Google Search Console. Leur interprétation dépend du rôle de l’URL et du comportement attendu. Une exclusion volontaire peut être normale. L’absence persistante d’une page importante mérite toutefois une analyse. Le diagnostic repose sur l’objectif de la page, la raison de son exclusion et la cohérence du statut affiché.
FAQ
Une page « non indexée » dans Search Console est-elle forcément en erreur ?
Non. Une page « non indexée » n’indique pas automatiquement un problème. Son statut doit être rapproché de sa fonction. Une URL volontairement exclue peut être normale. En revanche, une page stratégique absente de l’index Google mérite une analyse de son statut d’indexation et de sa cause.
Pourquoi Google connaît-il une page sans l’indexer ?
Google peut connaître une URL sans l’avoir intégrée à son index. La découverte signifie qu’il a identifié son existence. L’exploration correspond au passage de Googlebot. L’indexation intervient ensuite, lorsque Google traite le contenu et décide de conserver l’URL dans son index de recherche.
Faut-il chercher à supprimer toutes les erreurs indiquées dans Search Console ?
Non. Tous les signalements ne correspondent pas à des anomalies. Une redirection volontaire, une balise noindex ou une URL canonique correctement choisie peuvent expliquer une exclusion. L’enjeu consiste surtout à repérer les problèmes d’indexation qui touchent des pages réellement importantes pour le référencement.
Comment savoir si une URL devrait être indexée ?
Une URL a généralement vocation à être indexée lorsqu’elle apporte une information utile, possède un contenu suffisamment unique et répond à un objectif SEO clair. Sa valeur commerciale ou informationnelle compte aussi. Une page destinée à attirer du trafic organique doit normalement pouvoir rejoindre l’index Google.
Combien de temps attendre après avoir corrigé une erreur d’indexation ?
Il n’existe aucun délai garanti après une correction. Google doit réexplorer l’URL, puis retraiter ses informations avant une éventuelle réindexation. Le délai d’indexation varie selon le site, son rythme d’exploration et la nature de la modification effectuée.

Audrey L.


Tu pourrais aussi aimer

Google Pics : opportunité, limites et cas d’usage pour les entreprises
Les plugins essentiels pour optimiser votre e-commerce sur WordPress, PrestaShop et Shopify en 2025
